Home / Past papers / MLP Quiz 1 / this paper
2024 Oct27: - 27 Oct 2024
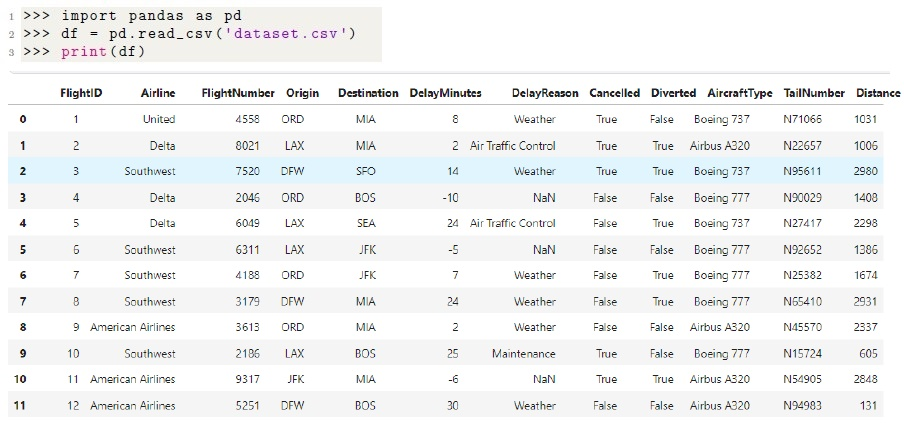
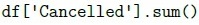
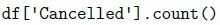
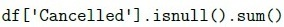
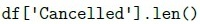
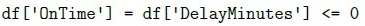
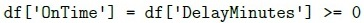

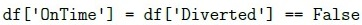
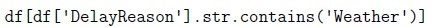
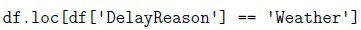
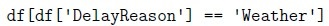
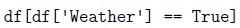
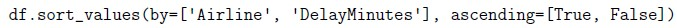
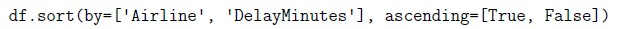
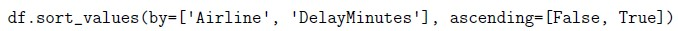
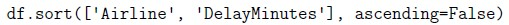
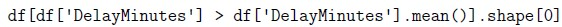
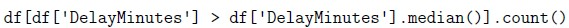
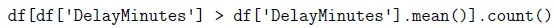
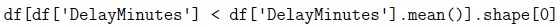
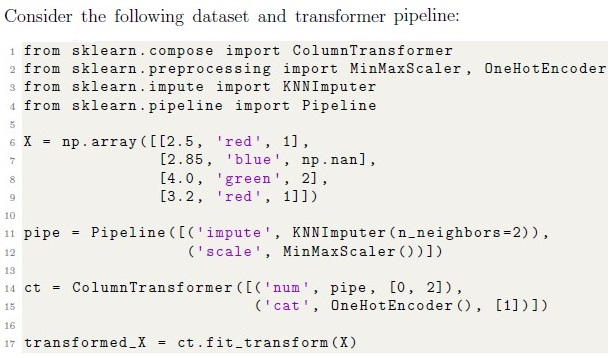
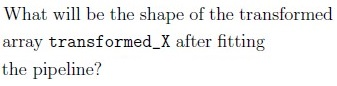
- (4, 5)
- (4, 6)
- (4, 7)
- (4, 8)
- None of these
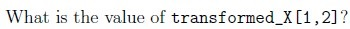
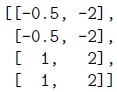
- 0.0
- 0.5
- -0.5
- 1
- None of these
- One-hot encoding
- StandardScaler
- Label encoding
- MinMaxScaler
- Filling with mean or median
- Deleting the rows with missing values
- Using a predictive model to estimate missing values
- Using a random generator to fill missing values
- Cross-validation helps prevent overfitting.
- It is a technique to improve the model’s accuracy.
- K-Fold cross-validation is one of the most popular types of cross-validation.
- Cross-validation is not suitable for small datasets.
- Squared Loss
- Hinge Loss
- Log Loss
- Mean Absolute Error
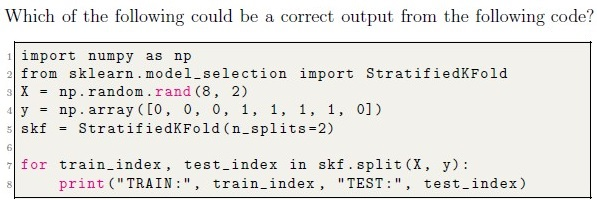
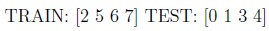
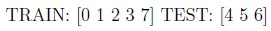
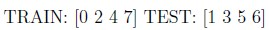
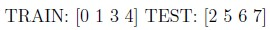
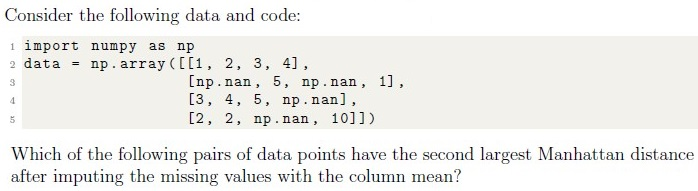
- 0 and 1
- 2 and 3
- 0 and 3
- 1 and 2
- 1 and 3
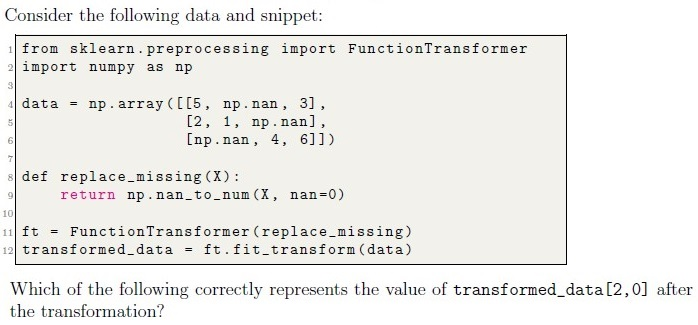
- 0
- 4
- 6
- None of these
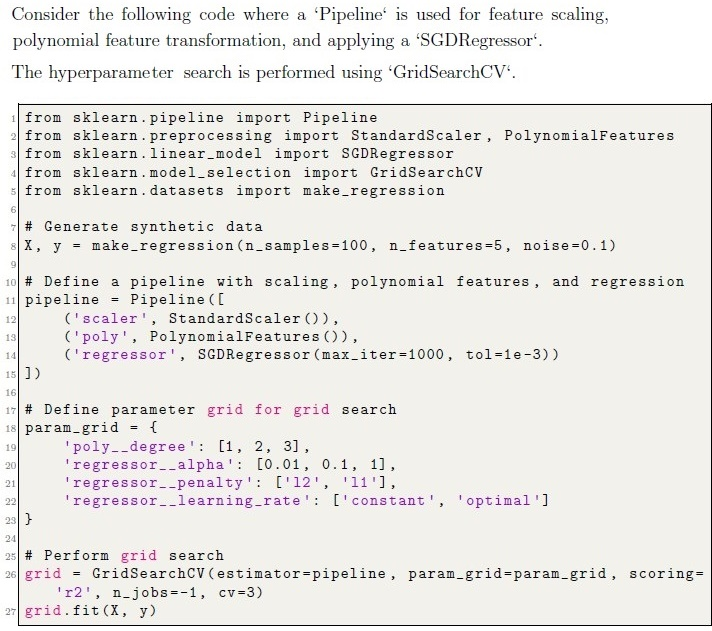
- 36
- 54
- 72
- 108
- 1 → 4 → 2 → 3 → 5
- 3 → 2 → 1 → 4 → 5
- 2 → 3 → 1 → 5 → 4
- 3 → 5 → 2 → 1 → 4
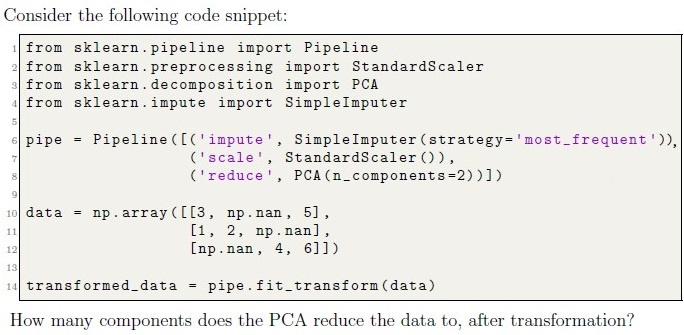
- 2
- 3
- 1
- None of these
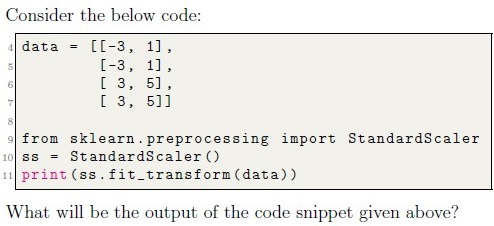


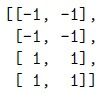
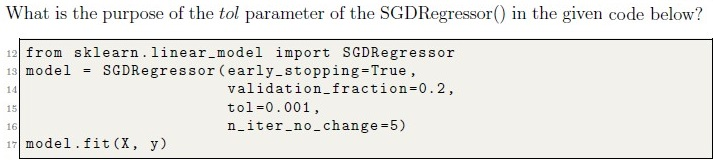
- It controls the learning rate of the stochastic regressor during training.
- It determines the maximum number of iterations for the training process.
- It defines the fraction of the validation set used for early stopping.
- It specifies the tolerance level for early stopping based on the change in thevalidation error.
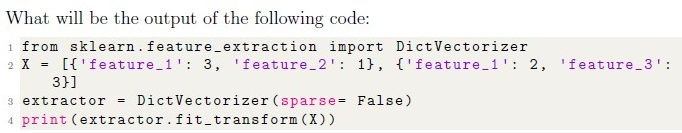
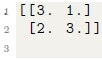

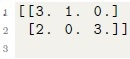
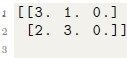
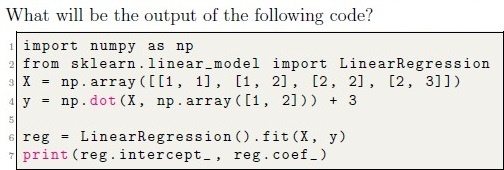
- Intercept: 3.0, Coefficients: [1.0, 2.0]
- Intercept: 3.0, Coefficients: [0.0, 2.0]
- Intercept: 0.0, Coefficients: [1.0, 2.0]
- Given code will return an error.
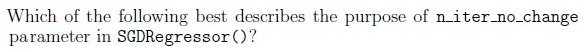
- Controls the total number of iterations.
- Specifies the tolerance level for early stopping.
- Defines the number of iterations with no improvement to stop training.
- Sets the learning rate schedule.
Answer key
- Q1 (MCQ, 2 marks): A
- Q2 (MCQ, 2 marks): A
- Q3 (MSQ, 3 marks): B, C
- Q4 (MCQ, 3 marks): A
- Q5 (MCQ, 3 marks): A
- Q6 (MCQ, 2 marks): A
- Q7 (MCQ, 3 marks): D
- Q8 (MSQ, 2 marks): A, C
- Q9 (MSQ, 2 marks): A, B, C
- Q10 (MSQ, 2 marks): A, C
- Q11 (MSQ, 2 marks): B, C
- Q12 (MSQ, 2 marks): A, D
- Q13 (MCQ, 3 marks): B
- Q14 (MCQ, 3 marks): A
- Q15 (MCQ, 3 marks): A
- Q16 (MCQ, 2 marks): D
- Q17 (MCQ, 2 marks): A
- Q18 (MCQ, 2 marks): D
- Q19 (MCQ, 2 marks): D
- Q20 (MCQ, 2 marks): C
- Q21 (MCQ, 2 marks): A
- Q22 (MCQ, 1 marks): C
Concepts this paper tests
Auto-generated summary from the source site. Handy as a checklist; the lessons above explain each idea from scratch.
Summary of Core Topics, Concepts, Principles, and Equations
1. Pandas DataFrame Operations
- Counting and Summing:
df['Cancelled'].sum(),df['Cancelled'].count() - Filtering:
df[df['DelayReason'] == 'Weather'] - Sorting:
df.sort_values(by=['Airline', 'DelayMinutes'], ascending=[True, False]) - Mean and Median:
df['DelayMinutes'].mean(),df['DelayMinutes'].median()
2. Data Preprocessing
One-Hot Encoding: Converting categorical variables into a form that can be provided to machine learning algorithms.
from sklearn.preprocessing import OneHotEncoder encoder = OneHotEncoder() encoded_data = encoder.fit_transform(categorical_data)StandardScaler: Standardizing features by removing the mean and scaling to unit variance.
from sklearn.preprocessing import StandardScaler scaler = StandardScaler() scaled_data = scaler.fit_transform(data)MinMaxScaler: Scaling features to a given range.
from sklearn.preprocessing import MinMaxScaler scaler = MinMaxScaler() scaled_data = scaler.fit_transform(data)KNNImputer: Imputing missing values using k-nearest neighbors.
from sklearn.impute import KNNImputer
imputer = KNNImputer(n_neighbors=2)
imputed_data = imputer.fit_transform(data)
3. Pipeline and ColumnTransformer
Pipeline: Sequentially applying a list of transforms and a final estimator.
from sklearn.pipeline import Pipeline pipeline = Pipeline([('impute', KNNImputer(n_neighbors=2)), ('scale', MinMaxScaler())]) transformed_data = pipeline.fit_transform(data)ColumnTransformer: Applying different transforms to different columns.
from sklearn.compose import ColumnTransformer
ct = ColumnTransformer([('num', pipeline, [0, 2]), ('cat', OneHotEncoder(), [1])])
transformed_data = ct.fit_transform(data)
4. Cross-Validation and Grid Search
StratifiedKFold: Providing train/test indices to split data in train/test sets.
from sklearn.model_selection import StratifiedKFold skf = StratifiedKFold(n_splits=2) for train_index, test_index in skf.split(X, y): print("TRAIN:", train_index, "TEST:", test_index)GridSearchCV: Exhaustive search over specified parameter values for an estimator.
from sklearn.model_selection import GridSearchCV
grid = GridSearchCV(estimator=pipeline, param_grid=param_grid, scoring='r2', n_jobs=-1, cv=3)
grid.fit(X, y)
5. Machine Learning Models
SGDRegressor: Linear model fitted by minimizing a regularized empirical loss with SGD.
from sklearn.linear_model import SGDRegressor model = SGDRegressor(max_iter=1000, tol=1e-3) model.fit(X, y)LinearRegression: Ordinary least squares Linear Regression.
from sklearn.linear_model import LinearRegression
model = LinearRegression()
model.fit(X, y)
6. Mathematical Equations
- Mean:
- Standard Deviation:
- Manhattan Distance: