Home / Past papers / MLF End Term / this paper
IIT M IMPROVEMENT AN EXAM QDD4 22 - 22 Dec 2024
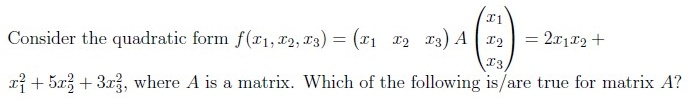
- A is a positive definite matrix.
- A is not a singular matrix.
- A is not a symmetric matrix.
- A is a negative definite matrix.
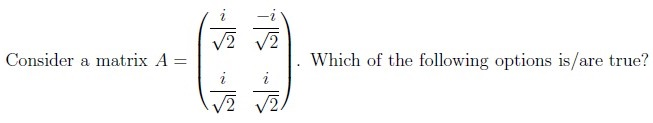
- A is not a unitary matrix.
- A is Hermitian matrix.
- Eigenvectors of A are orthogonal.
- Eigenvalues of A are not real.
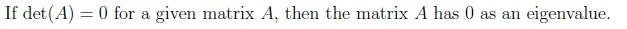
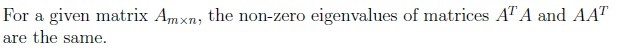
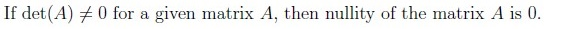
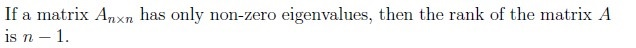
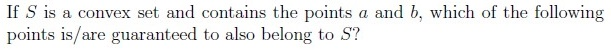
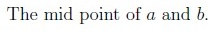
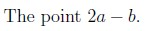
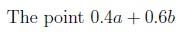
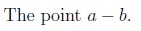
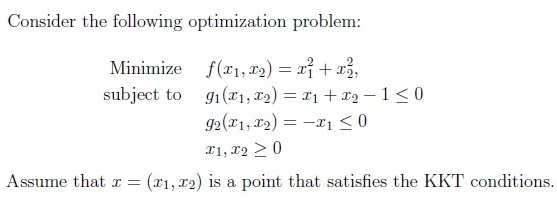
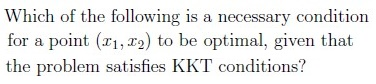

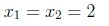
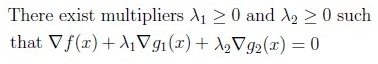
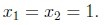
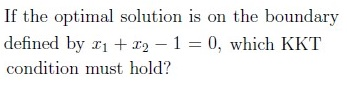
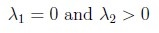
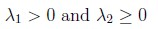
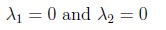
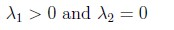
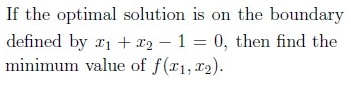
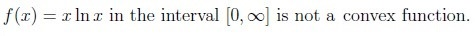
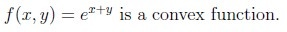
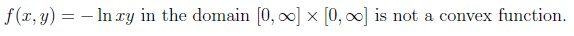
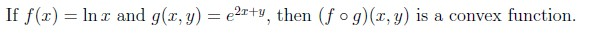
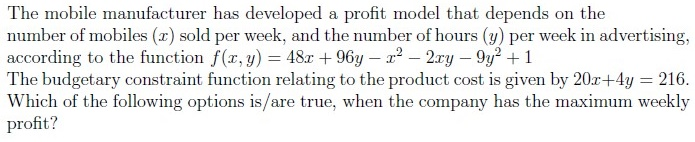


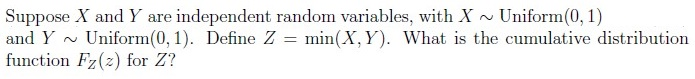
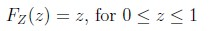
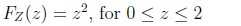
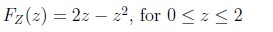
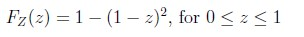
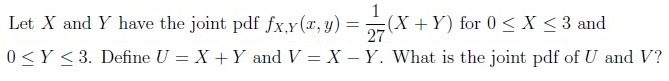
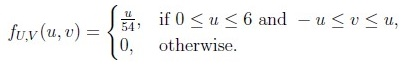
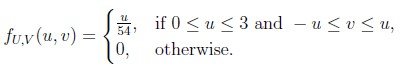
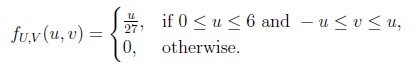
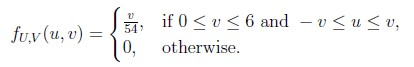
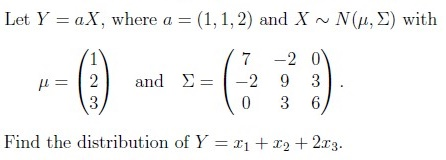
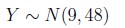
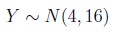
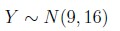
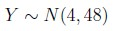
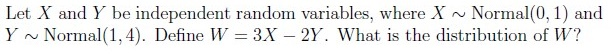
- Normal(−2, 7)
- Normal(−2, 13)
- Normal(−2, 25)
- None of these
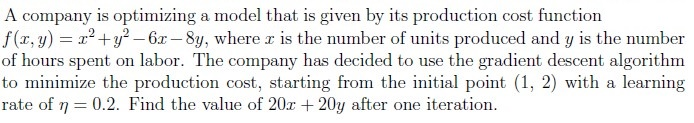
Answer key
- Q1 (MSQ, 3 marks): A, B
- Q2 (MSQ, 3 marks): C, D
- Q3 (MSQ, 3 marks): A, B, C
- Q4 (MSQ, 3 marks): A, C
- Q5 (MCQ, 2 marks): C
- Q6 (MCQ, 3 marks): B
- Q7 (SA, 1 marks): 1
- Q8 (MSQ, 4 marks): B, D
- Q9 (MSQ, 4 marks): A, C
- Q10 (MCQ, 3 marks): D
- Q11 (MCQ, 3 marks): A
- Q12 (MCQ, 3 marks): A
- Q13 (MCQ, 2 marks): C
- Q14 (SA, 3 marks): 92
Concepts this paper tests
Auto-generated summary from the source site. Handy as a checklist; the lessons above explain each idea from scratch.
Here’s a structured summary of core topics, concepts, principles, and equations for the Diploma Level: Machine Learning Foundations (Computer-Based Exam), along with Mermaid knowledge graphs to visualize relationships.
Core Topics & Key Concepts
1. Linear Algebra & Matrix Theory
Key Concepts:
Quadratic Forms & Positive Definiteness
- A quadratic form: .
- Positive Definite Matrix: for all .
- Eigenvalues: All eigenvalues of a positive definite matrix are positive.
- Singular Matrix: ⇒ at least one eigenvalue is zero.
- Symmetric Matrix: .
Eigenvalues & Eigenvectors
- For a matrix , .
- Unitary Matrix: (conjugate transpose).
- Hermitian Matrix: .
- Orthogonal Eigenvectors: Eigenvectors of a Hermitian matrix are orthogonal.
- Eigenvalues of Unitary Matrices: Lie on the unit circle (magnitude 1).
Determinant & Rank
- ⇒ singular matrix ⇒ at least one eigenvalue is zero.
- Rank-Nullity Theorem: .
- If , then .
- Non-zero eigenvalues of and : Same for any matrix .
Key Equations:
- Quadratic Form Expansion:
where
- Eigenvalue Equation:
- Rank-Nullity:
2. Convex Optimization
Key Concepts:
Convex Sets
- A set is convex if for any , for .
Examples of Convex Combinations:
- Midpoint:
- Weighted average:
Convex Functions
- A function is convex if:
Examples:
- (convex)
- (convex for )
- (convex for )
- Composition of convex functions is convex.
KKT Conditions (Karush-Kuhn-Tucker)
- Necessary conditions for optimality in constrained optimization.
- For a problem:
KKT conditions require:
- Stationarity:
- Primal Feasibility: ,
- Dual Feasibility:
- Complementary Slackness:
Key Equations:
- Convex Combination:
- KKT Lagrangian:
- Gradient Condition:
3. Probability & Statistics
Key Concepts:
Joint & Marginal Distributions
- Given , find for using transformation techniques.
- Jacobian Determinant for change of variables.
Order Statistics
- For independent , the CDF of is:
Multivariate Normal Distribution
- If , then .
Linear Combinations of Normals
- If , , then:
Key Equations:
- CDF of Minimum of Uniforms:
- Linear Combination of Normals:
- Transformation of Variables:
where is the Jacobian determinant.
4. Optimization Problems
Key Concepts:
Gradient Descent
- Update rule:
- Learning Rate (): Step size in gradient descent.
Constrained Optimization
- Use Lagrange Multipliers or KKT Conditions for inequality constraints.
Key Equations:
- Gradient Descent Update:
- Lagrangian for Constrained Optimization:
2. Convex Optimization
3. Probability & Statistics
4. Optimization Algorithms
Summary of Key Equations
| Topic | Key Equation |
|---|---|
| Quadratic Form | |
| Positive Definite | for all |
| Eigenvalue Equation | |
| Rank-Nullity | |
| Convex Combination | , |
| KKT Conditions | |
| CDF of Min Uniforms | |
| Linear Normals | |
| Gradient Descent |
Exam Preparation Tips
Linear Algebra:
- Practice constructing matrices from quadratic forms.
- Know how to check positive definiteness, eigenvalues, and singularity.
Convex Optimization:
- Understand convex sets, functions, and KKT conditions.
- Solve small optimization problems using KKT.
Probability:
- Master transformations of random variables (Jacobian).
- Know properties of Uniform and Normal distributions.
Optimization Algorithms:
- Be comfortable with gradient descent updates.
- Understand constrained optimization (Lagrange multipliers).
This summary covers all key topics from the question paper. Focus on equations, definitions, and problem-solving techniques for the exam. Good luck! 🚀