Home / Past papers / MLF End Term / this paper
IIT M DIPLOMA AN EXAM QDD4 13 Apr 2025 - 13 Apr 2025
Elapsed 00:00
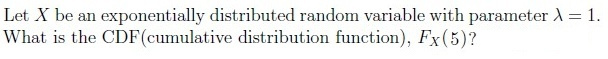
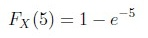
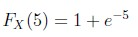
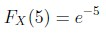
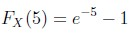
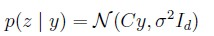
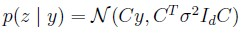
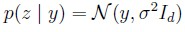
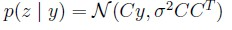
Which of the following statements about singular value decomposition (SVD) is/are true?
- Singular value decomposition is possible only for a square matrix.
- Singular value decomposition is possible only for a symmetric matrix.
- The singular values of a matrix are always non-negative.
- The singular values of matrices A and AT are the same.
In the context of Linear Algebra, which of the following statements about Principal Component Analysis (PCA) is/are true?
- The principal components of a matrix are given by the eigenvectors of itscovariance matrix.
- The principal components of a matrix are given by the singular values of itscovariance matrix.
- PCA finds the principal components by maximizing the variance along eachcomponent.
- The principal components form a basis that is not necessarily orthogonal.
Which of the following options is/are true?
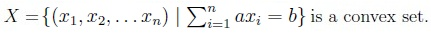
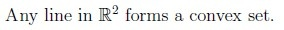
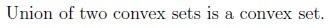
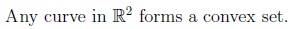
Which of the following options is/are true ?
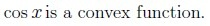
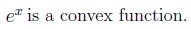
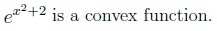
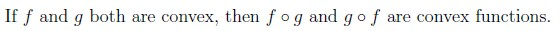
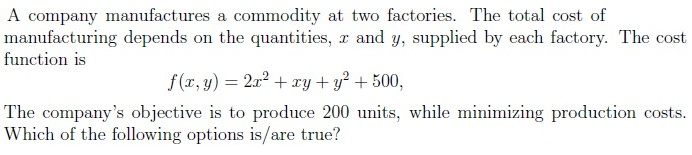
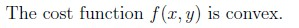
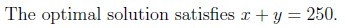
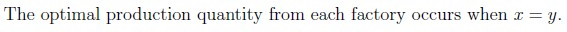
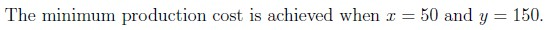
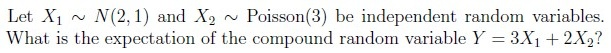
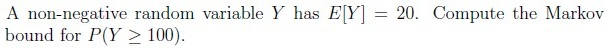
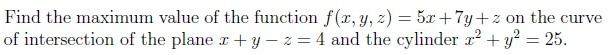
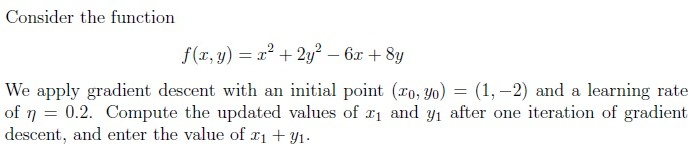
Comprehension passage - the questions below it refer to this
Based on the above data, answer the given subquestions.
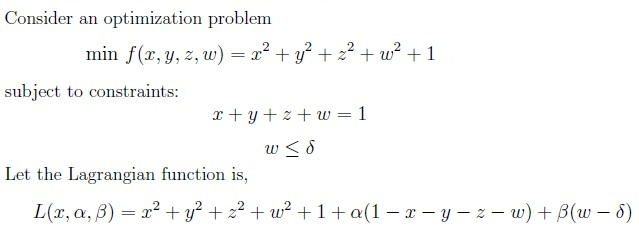
Which of the following statements correctly represent the Karush-Kuhn-Tucker (KKT) conditions for the given optimization problem?


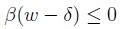
Which of the following statements are correct based on the KKT conditions and the solution to the optimization problem?
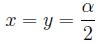
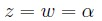
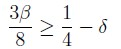
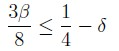
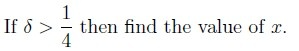
Answer key
- Q1 (MCQ, 2 marks): A
- Q2 (MCQ, 3 marks): A
- Q3 (MSQ, 3 marks): C, D
- Q4 (MSQ, 3 marks): A, C
- Q5 (MSQ, 3 marks): A, B
- Q6 (MSQ, 3 marks): B, C
- Q7 (MSQ, 3 marks): A, D
- Q8 (SA, 3 marks): 12
- Q9 (SA, 3 marks): 0.2
- Q10 (SA, 4 marks): 46
- Q11 (SA, 2 marks): -0.2
- Q12 (MSQ, 2 marks): A, C
- Q13 (MSQ, 3 marks): A, C
- Q14 (SA, 3 marks): 0.25
Concepts this paper tests
Auto-generated summary from the source site. Handy as a checklist; the lessons above explain each idea from scratch.
Here’s a structured summary of core topics, concepts, principles, and equations essential for the exam, followed by Mermaid knowledge graphs to visualize relationships.
1. Core Topics & Key Concepts
A. Probability & Statistics
Exponential Distribution
- CDF: (for , ).
- PDF: .
Gaussian (Normal) Distribution
- Conditional Probability: For where , .
- Linearity of Expectation: .
Markov’s Inequality
- For non-negative , .
- Example: .
B. Linear Algebra & Optimization
Singular Value Decomposition (SVD)
Properties:
- Applicable to any matrix (not just square/symmetric).
- Singular values are non-negative.
- Singular values of and are identical.
Principal Component Analysis (PCA)
Key Ideas:
- Principal components = eigenvectors of the covariance matrix.
- Maximizes variance along each component.
- Basis is orthogonal.
Convexity
Convex Sets:
- Linear constraints (e.g., ) define convex sets.
- Lines in are convex; unions of convex sets are not necessarily convex.
Convex Functions:
- , are convex.
- Composition is not guaranteed convex.
Optimization:
- Convex cost functions (e.g., ) have global minima.
KKT Conditions for constrained optimization:
- (stationarity).
- (complementary slackness).
- (dual feasibility).
Gradient Descent
- Update Rule: .
- Example: For , . With , .
C. Calculus & Constrained Optimization
Lagrange Multipliers
- Lagrangian: .
KKT Conditions:
- , , (for inequalities).
Maximization on Constraints
Example: Maximize on and .
- Use Lagrange multipliers or parameterize the cylinder.
2. Key Equations
| Topic | Equation |
|---|---|
| Exponential CDF | |
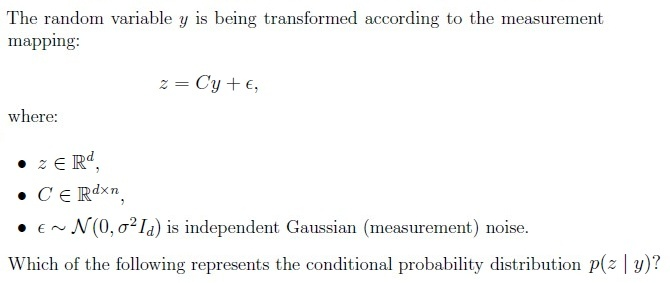
| Gaussian Conditional | |
| Markov’s Inequality | |
| SVD | (singular values ) |
| PCA | Covariance matrix eigenvectors principal components |
| Convex Function | |
| Gradient Descent | |
| KKT Conditions | , , |
| Lagrange Multipliers |
Graph 2: Linear Algebra & Optimization
Graph 3: Calculus & Constrained Optimization
4. Exam Tips
- Probability: Focus on CDF/PDF of exponential/Gaussian distributions and conditional probability.
- Linear Algebra: SVD properties, PCA (eigenvectors vs. singular values), and convexity.
- Optimization: KKT conditions, gradient descent updates, and Lagrange multipliers.
- Calculus: Maximization/minimization on constraints (use substitution or Lagrange multipliers).