Home / Past papers / MLF End Term / this paper
IIT M FOUNDATION DIPLOMA FN EXAM - 22 Dec 2024
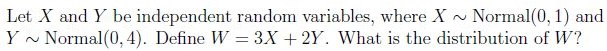
- Normal(5, 11)
- Normal(0, 11)
- Normal(0, 25)
- Normal(5, 25)
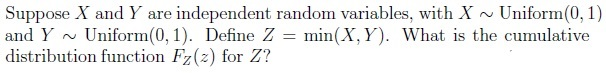
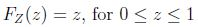
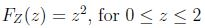
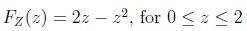
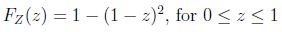
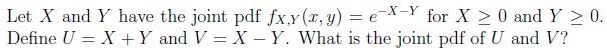
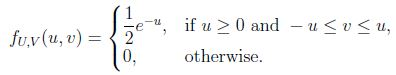
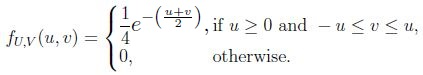
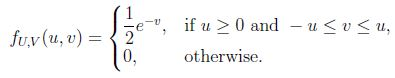
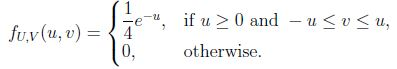
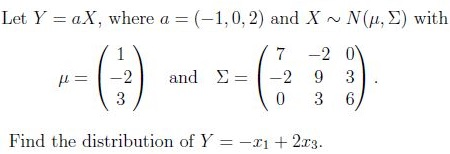
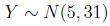
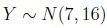
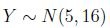
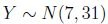
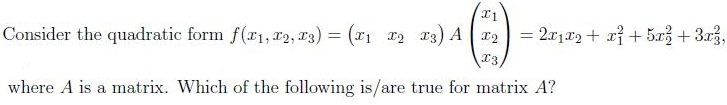
- A is a positive definite matrix.
- A is singular matrix.
- A is a symmetric matrix.
- A is a negative definite matrix.
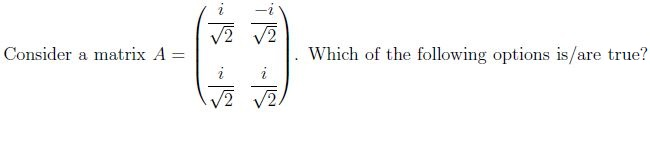
- A is a unitary matrix.
- A is Hermitian matrix.
- Eigenvectors of A are orthogonal.
- Eigenvalues of A are real.
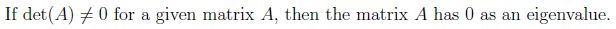
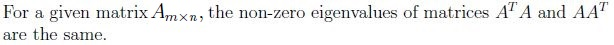
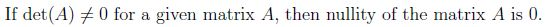
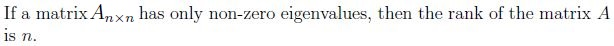
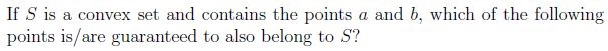
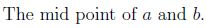
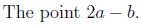
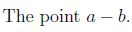
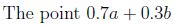
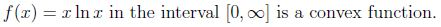
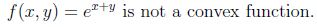
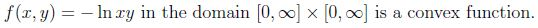
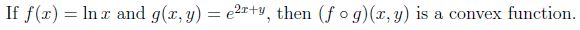


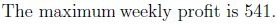
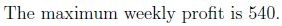
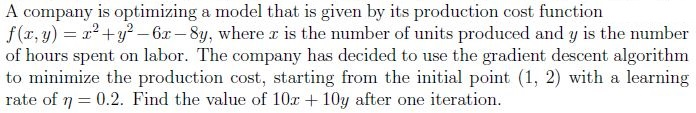
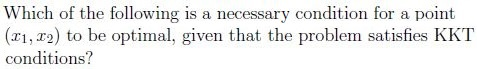

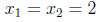
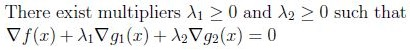
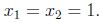
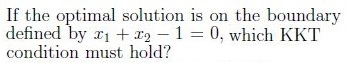
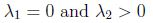
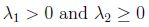
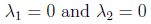
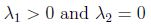
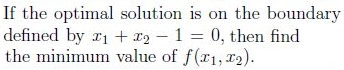
Answer key
- Q1 (MCQ, 2 marks): C
- Q2 (MCQ, 3 marks): D
- Q3 (MCQ, 3 marks): A
- Q4 (MCQ, 3 marks): A
- Q5 (MSQ, 3 marks): A, C
- Q6 (MSQ, 3 marks): A, C
- Q7 (MSQ, 3 marks): B, C, D
- Q8 (MSQ, 3 marks): A, D
- Q9 (MSQ, 4 marks): A, C, D
- Q10 (MSQ, 4 marks): A, C
- Q11 (SA, 3 marks): 46
- Q12 (MCQ, 2 marks): C
- Q13 (MCQ, 3 marks): B
- Q14 (SA, 1 marks): 1
Concepts this paper tests
Auto-generated summary from the source site. Handy as a checklist; the lessons above explain each idea from scratch.
Here’s a structured summary of core topics, concepts, principles, and equations essential for this exam, followed by Mermaid knowledge graphs to visualize relationships.
Core Topics & Key Concepts
1. Probability & Random Variables
Distributions:
Normal Distribution: .
- Linear combinations: If and , then .
- Key Equation:
Uniform Distribution: .
- CDF of : For independent ,
Exponential Distribution: Joint PDF for .
- Transformation of Variables: For , , the joint PDF is:
Multivariate Normal Distribution:
- . For , .
- Key Equation:
2. Linear Algebra
Matrix Properties:
- Positive Definite: is positive definite if for all .
- Symmetric Matrix: .
- Quadratic Forms: . For , is:
(Symmetric and positive definite.)
Eigenvalues/Eigenvectors:
- Unitary Matrix: . For complex matrices, check .
- Hermitian Matrix: . Eigenvalues are real; eigenvectors are orthogonal.
Key Facts:
- Non-zero eigenvalues of and are identical.
- implies nullity (no zero eigenvalues).
- Full-rank has .
3. Convexity & Optimization
Convex Sets:
- A set is convex if for all , .
- Examples: Midpoint and are in .
Convex Functions:
- is convex if .
Examples:
- (convex on ).
- (convex, as Hessian is positive semidefinite).
- (convex on ).
- Composition: If is convex and non-decreasing, and is convex, then is convex.
Optimization Algorithms:
- Gradient Descent: Update rule:
Example: For , . Starting at , first iteration:
.
KKT Conditions:
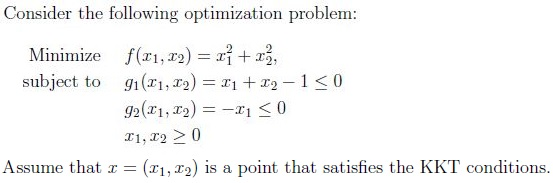
For constrained optimization s.t. , KKT requires:
- Stationarity: .
- Primal Feasibility: .
- Dual Feasibility: .
- Complementary Slackness: .
- Example: For with , , optimal satisfies:
If on boundary , then , .
4. Applications
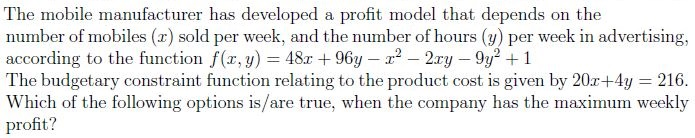
Profit Maximization:
- Use Lagrange multipliers for constrained optimization.
- Example: Maximize s.t. . Solve to find , , profit .
2. Linear Algebra
3. Convexity & Optimization
4. Applications
Key Equations Summary
| Topic | Equation |
|---|---|
| Normal Linear Combination | |
| CDF of min(X,Y) | (Uniform) |
| Joint PDF Transformation | (Exponential) |
| Multivariate Normal | |
| Quadratic Form | (Positive definite if is PD) |
| Gradient Descent | |
| KKT Conditions | , |
| Convex Function |